Проверить, что посчитано
Задать схему, определить ключ строки, обработать даты и NULL. Сверить фильтр и агрегат с исходными записями.
Вопрос: почему изменилось число строк?
Начнёшь с небольшого CSV и первых ячеек Jupyter. Научишься читать план, связывать его со Spark UI и проверять результат. Затем применишь это к задачам, где данные или выполнение уже пошли не так.
Курс в разработке. Локально готовы первые 3 модуля.
 Увеличить
Воспроизвести симптом → собрать факты → проверить гипотезу → исправить причину → подтвердить результат.
Успешный Job ещё требует проверки результата. Медленная Task требует наблюдений. В курсе ты учишься разбирать оба случая.
Задать схему, определить ключ строки, обработать даты и NULL. Сверить фильтр и агрегат с исходными записями.
Прочитать explain("formatted"), найти чтение, фильтр и Exchange. Объяснить, где Spark перераспределяет данные.
Связать action с Job, Stage и Tasks. Проверить партиции, ресурсы и повторные вычисления по своему запуску.
Проверить гипотезу отдельным опытом, сравнить результат до и после, повторить расчёт на другом входе.
В Stepik читаешь подробный разбор и отвечаешь на вопросы. В Jupyter запускаешь короткие ячейки, меняешь условия и пишешь решение. Пример начинается с небольших данных, которые можно проверить строка за строкой.
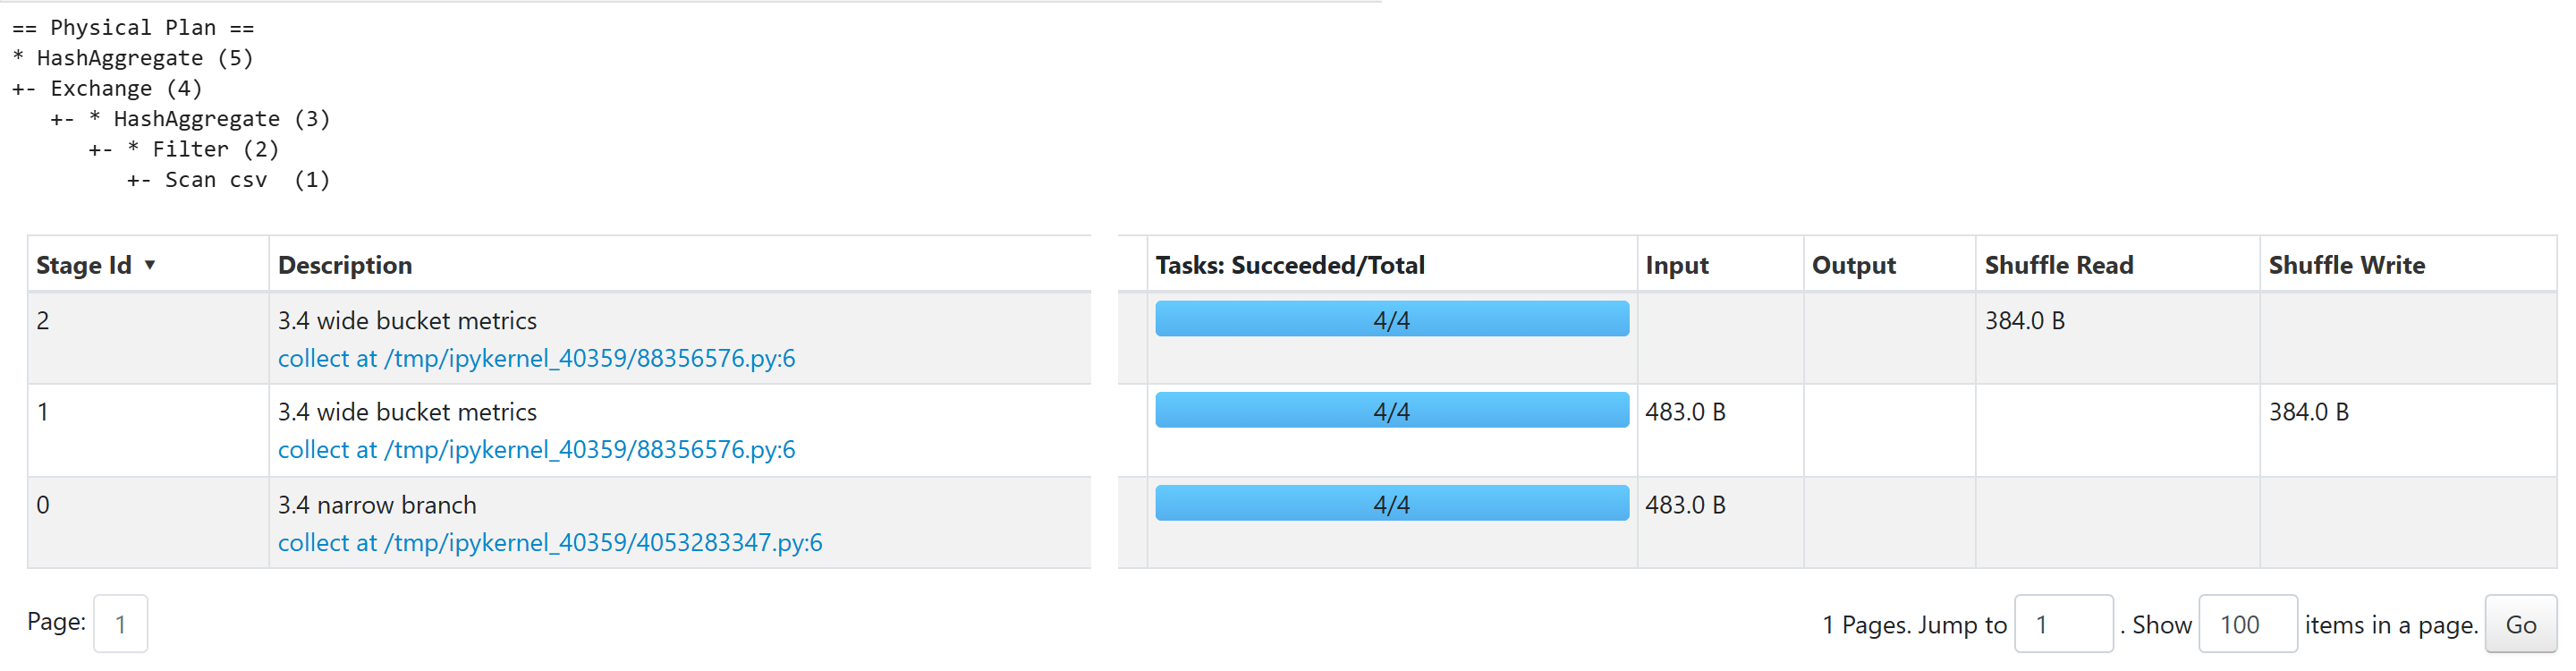
Находишь Exchange в плане, затем сопоставляешь его с передачей данных между Stage.
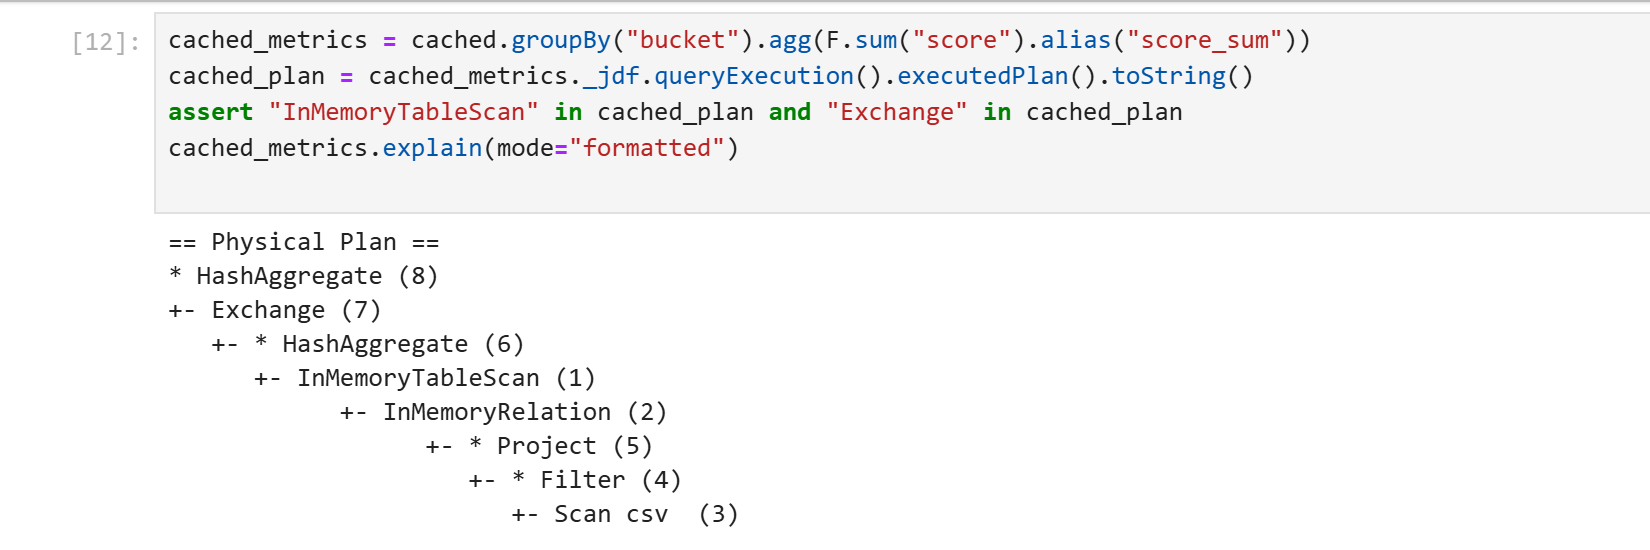
Исследуешь повторное выполнение и cache(), затем проверяешь, что изменилось в плане.
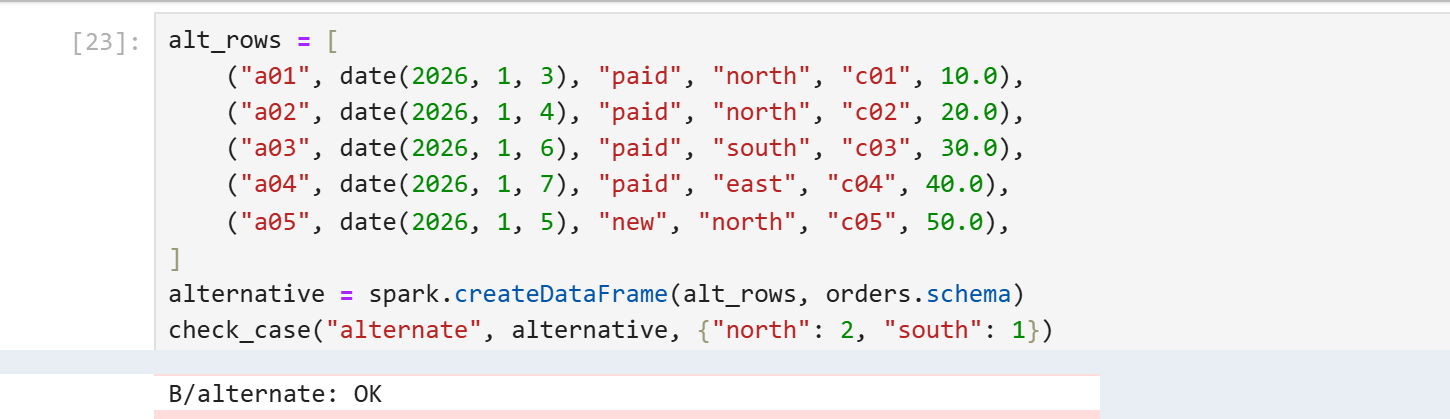
В технических уроках есть задачи A на отработку темы и более сложные задачи B. Checker даёт обратную связь по коду.
Нажми на изображение, чтобы рассмотреть детали.Вопросы проверяет Stepik. Код проверяется локально в notebook. Ручной сдачи нет; локальный checker не отправляет решение на платформу.
В лаборатории ты получишь тикет, исходные данные и проблемный job. Выбор проверки останется за тобой. Перед этим соответствующий механизм будет разобран в обучающих уроках.
join сумма заказов вырослаРасчёт завершился без ошибки. Результат расходится с контрольной суммой. Твоя задача: найти источник расхождения и сохранить корректную логику расчёта.
Какая строка должна быть уникальна? Есть ли несколько совпадений на ключ?
Какие стороны и выражения участвуют в join?
На каком наборе записей появляются дополнительные строки?
Исследуешь распределение строк, ключи и метрики задач.
Проверяешь структуру dataset и условия отбора партиций.
Связываешь партиции расчёта с физическими файлами результата.
Лаборатории входят в план модулей 6–7 и сейчас разрабатываются. На странице показан их задуманный формат.
Склонируешь открытый репозиторий, поднимешь контейнеры и откроешь JupyterLab. Команды запуска, проверки и разбор типовых ошибок будут под рукой в документации стенда.
НачалоJupyter, Spark Master и два Worker. В приложении проверяешь регистрацию двух Executor.
ХранениеMinIO включается отдельным профилем для работы через s3a://.
ИсторияHistory Server нужен для разбора завершённых приложений и event logs.
Сначала освоишь механизмы на понятных опытах. Затем соединишь их в инженерных задачах. Программа разделена на семь модулей.
Зачем нужен Spark, установка окружения, работа с ячейками и kernel. Первый запуск приложения, Driver, Master, Worker и Executor.
Результат: открываешь Jupyter и находишь своё приложение в кластере.Типы и ключи данных, transformations и actions, lazy execution, даты и NULL, агрегации и первый shuffle. Один расчёт через DataFrame API и SQL, проверка значений.
array, struct и explode запланированы отдельным дополнительным уроком.Уровни плана, параллелизм, narrow и wide transformations, Exchange, повторные actions и cache. Границы ресурсов Driver и Executor, ошибки и поиск логов.
Доступ через S3A, CSV и Parquet, запись и повторное чтение, partitionBy, pruning и pushdown. repartition, coalesce и маленькие файлы.
Ключи и число совпадений, типы соединений, несовпавшие строки. SortMergeJoin и BroadcastHashJoin, статистики и AQE, перекос данных и оконные функции.
Результат: проверяешь корректность соединения и выбранную стратегию.Приложение не видно в кластере. Метрика выросла после join. Одна Task задерживает Stage. Неожиданный shuffle, лишнее чтение и слишком много выходных файлов.
Получишь тикет, данные и проблемный job. Соберёшь факты, проверишь гипотезы, исправишь расчёт и проверишь сохранение требований к результату.
Результат: объясняешь, что произошло и почему исправление работает.Готовность локальных материалов не означает публикацию на Stepik. Дата открытия и порядок доступа к модулям пока не объявлены.
После завершения разработки: 15 000 ₽
Скидка 3 000 ₽ за ранний доступ
Теория, практика в Jupyter и самостоятельные задания с проверками.
Курс ещё в разработке. Сейчас ты проходишь готовые уроки, а новые темы и лабораторные получаешь по мере публикации. Когда я закончу разработку, у тебя будет доступ ко всему курсу по программе.
Напиши мне «Spark» в Telegram, @dim4eg91. Пришлю ссылку на ранний доступ за 12 000 ₽.
Пока нет: курс в разработке. Локально готовы первые три модуля: запуск окружения, DataFrame, планы и Spark UI. Файлы, соединения и лаборатории ещё разрабатываются. Новые уроки добавляю по мере готовности. Покупка раннего доступа включает весь курс по программе без доплаты.
Доступ к готовым урокам и всем следующим урокам и лабораторным по программе этого курса. Сейчас действует скидка 3 000 ₽ за ранний доступ. После завершения разработки цена курса составит 15 000 ₽; тебе доплачивать разницу не нужно.
Да, если есть базовые Python и SQL. Начнём с назначения Spark, установки окружения и работы в Jupyter. Новые механизмы будем разбирать на небольших примерах.
Основной формат: подробный текст на Stepik, схемы, настоящие скриншоты и Jupyter notebooks. В notebook короткие ячейки с объяснениями, примерами и самостоятельными задачами.
Вопросы проверяет Stepik. Практический код проверяется локально в notebook. Ручной сдачи и обязательного ревью нет. Локальная проверка не отправляет код на Stepik.
Проверенный ориентир для Windows: 16 ГБ RAM у компьютера, около 8 ГБ для Docker, 4 CPU и 15 ГБ свободного места. Нужны Docker Desktop с Linux containers, PowerShell 7 и Git. Это ориентир по текущему стенду; подробности есть в его документации.
Нет. У Spark-курса собственный стенд и самостоятельный учебный маршрут. Базу Python и SQL нужно иметь до начала.
В первой версии курс посвящён batch-обработке в PySpark. Structured Streaming, Scala, MLlib, Kubernetes и облачные платформы в эту программу не входят.